从云托管到自托管:我们如何把节点数据的所有权交还给用户
本文记录 Stash Wallet「节点数据导出」的设计过程:为什么云节点必须提供数据出口、两套方案的真实权衡、我们为什么最终选择方案 A,以及用户如何用导出的备份在自己的机器上重建同一个 RGB 闪电节点。
一、为什么必须做这件事
Stash Wallet 提供云节点:用户不需要自己跑 Docker、不需要维护一台 24/7 在线的机器。对多数用户来说这是正确的默认值——闪电节点掉线意味着收不到款,通道对手方还可能强制关闭通道。
Stash Cloud 一直在为云节点做自动备份。 这是平台侧的常规能力:节点数据定期落到独立的存储中,机器故障、容器异常、误操作导致数据损坏时,我们能把节点恢复到最近的可用状态,用户通常察觉不到发生过什么。这一层保障是默认开启的,不需要用户做任何事。
但它解决的是服务可用性问题,不是所有权问题。自动备份存在基础设施服务商的存储里,由服务商管理、由服务商决定何时恢复。它能挡住绝大多数技术故障,唯独挡不住一件事:用户想通过自己保管节点数据,并且不依赖任何一个基础设施服务商,就可以运行 RGB 闪电网络节点。
这就是云节点绕不开的那个问题:用户的通道状态和 RGB 资产分配,物理上存放在服务商的云盘里。
助记词一直在用户自己手上,这点从第一天就是如此。可对闪电网络而言,助记词不等于全部:
- 通道状态记录每条通道的最新承诺交易与撤销密钥。丢了它,即使有助记词,也无法安全地关闭通道取回资金。
- RGB 状态记录资产的分配与转移历史。丢了它,链上的 UTXO 还在,但无法证明它承载了哪些 RGB 资产。
换句话说:助记词保管的是「钱的所有权」,节点数据保管的是「钱的可取回性」。 只交出前者,用户对资产的控制权是不完整的。
所以这个功能的目标不是「补上一个缺失的备份」——备份本来就有。它要补的是那条用户自己掌控的出口:让用户随时把节点数据完整拿走,并且能在自己的机器上真正跑起来。不是导出一个只能存着的归档,而是一条经过验证的迁移路径。
自动备份保证的是「服务商能帮你恢复」,数据导出保证的是「你不需要服务商也能恢复」。这两件事都要有。
二、先把交付物定义清楚
动手编排之前,我们先把上游 rgbldkd backup export 产出的归档拆开验证了一遍。这一步不能靠文档推断,必须拆真实文件。两条结论决定了后面所有设计:
1. 归档不含私钥材料。 备份文件单独泄露不足以盗币。恢复需要「助记词 + 备份文件」两件套,缺一不可:助记词重建密钥,备份文件重建通道与 RGB 状态。
2. manifest.json 里的 master_fingerprint 是两件套的绑定凭据。
{
  "format_version": 1,
  "network": "regtest",
  "created_at_unix_secs": 1783956432,
  "rgbldkd_version": "0.7.0-bitlight.1",
  "master_fingerprint": "90820cfd",
  "node_alias": "Node 1",
  "files": [{ "path": "…", "size": 405504, "sha256": "1ab12f3e…" }]
}
恢复时会拿这个 fingerprint 与助记词初始化出的密钥比对,不匹配直接拒绝——「拿错备份」或「用错助记词」在第一步就被挡住,而不是产出一个坏节点。
三、真正的技术难点
需求听起来很简单:读一遍节点的数据盘,打包,上传。难点在于节点正在使用这块盘。
云上的数据盘同一时刻只能被一台运行中的机器挂载——这是块存储的基本语义,不是配置能绕开的。所以「节点照常跑,旁边再开一个进程读盘」这条路不存在。
更关键的是,即使能读到一块正在被写入的盘,产出的归档很可能是坏的。 节点运行时数据库随时在写,读到的可能是写了一半的中间状态。而这种损坏在导出时不会报任何错:用户拿到一个看起来正常的文件,几个月后真需要恢复时才发现读不出来。这是最坏的失败模式——静默损坏,且暴露在用户最需要它的那一刻。
所以只有两条路:让节点先停下来,独占读盘,或者先给盘拍一张快照,读快照。
四、方案 A vs. 方案 B
4.1 方案 A:节点停机,独占读盘
锁定节点 ──► 停止节点,数据盘卸载 ──► 临时任务独占挂载,导出、上传 ──► 节点重新启动这里有个容易搞错的点:锁定节点不等于数据一致,进程真正退出才等于。 锁定只挡住业务层的新支付、新通道、新资产操作,但进程还活着,数据库缓冲区里可能还有没落盘的内容。真正的强制落盘发生在进程退出的那一刻。
方案 A 的一致性是最强的:拿到的是进程正常退出、所有数据完整落盘之后的状态,等价于用户自己规规矩矩关机后再拷盘。代价是用户节点停机约 1 分钟——实测一次完整导出(含节点停止、导出、上传、节点重新拉起)总耗时 52.1 秒。
4.2 方案 B:快照副本
锁定节点 ──► 拍快照(数秒)──► 立即解锁,节点恢复服务
                    │
          由快照创建一块副本盘 → 在副本上导出、上传 → 清理副本
拍快照只需要几秒,之后节点立刻恢复服务,全部导出工作都发生在副本盘上。看起来 B 完胜——不停机,用户零感知。
但 B 有一个决定性的代价:数据一致性等级下降。
快照是崩溃一致性(crash-consistent)的,语义上等价于「给一台正在运行的机器直接拔电」。节点进程此刻还活着,所以快照里可能存在:数据库事务日志还没合并回主文件、缓冲区里的内容根本没进快照。副本能不能读出完整数据,取决于数据库自身的日志恢复机制能不能把它修回一致状态——这是一个概率问题,而不是一个确定性保证。
4.3 两案对比
| 方案 A(停机独占) | 方案 B(快照副本) | |
|---|---|---|
| 用户节点停机 | 约 1 分钟(实测 52 秒) | 无(仅锁数秒) |
| 数据一致性 | 确定:进程正常退出后的完整状态 | 崩溃一致,依赖数据库日志恢复 |
| 数据时点 | 导出瞬间 | 快照瞬间 |
| 实现复杂度 | 低 | 高(多一层副本资源的生命周期管理) |
五、为什么我们选了方案 A
B 的「不停机」是个很有诱惑力的卖点,我们也认真评估过。最终选 A,理由按重要性排序如下。
5.1 备份的唯一价值是「一定能恢复」
这是决定性的一条。
一个备份功能的全部意义,在于它被用到的那一刻能把数据还原出来。如果恢复是概率性的,那这个功能等于没做——用户以为自己有备份,实际上手里是一张彩票。
方案 A 给出的是确定性:进程正常退出、内核完成落盘,之后再读盘。这跟用户自己「先关掉节点,再拷走数据目录」是同一件事,不依赖任何恢复机制生效。
方案 B 依赖数据库的日志恢复把崩溃一致的副本修回可用状态。这个机制大概率有效,但「大概率」这个词放在通道状态上是不能接受的:通道状态错了不只是数据丢失,还可能导致用广播过期的承诺交易——那是会被对手方罚没的。
为了省这不到 1 分钟的停机,去换一个概率性的备份,这笔交易不划算。
5.2 停机是用户主动选择的,且完全可预期
再看这不到 1 分钟到底有多贵。
关键在于:这不是我们随机让用户的节点掉线,而是用户自己点了「导出」这个按钮。 用户完全知情、自己选时机、可以挑没有交易的时候做。我们在 UI 上明确写「预计 1 分钟左右节点不可用,期间无法收付款」,用户勾选确认后才开始。
这与「我们后台悄悄让节点停一分钟」是两件性质完全不同的事。一次用户主动发起、有明确预期的一分钟停机,换一个确定可恢复的备份——绝大多数用户会认为这是划算的。
我们还做了两件事把这个代价压到最低:导出前做完整预检(节点状态、锁定状态、平台并发额度),任一不过就直接拒绝,绝不让用户先付停机代价再失败;全局并发限流,避免同时有大量节点在停机窗口内。
5.3 一句话总结取舍
方案 B 用备份的确定性换用户的零感知;方案 A 用用户一次知情的一分钟换备份的确定性。
备份可以让用户多等一分钟,但不能让用户赌。
六、用户侧:从 Stash Wallet 导出备份
导出入口在 设置 → 钱包安全,紧随「导出助记词」之后。位置是刻意的:助记词 + 备份文件是一套东西,我们希望用户在同一个地方完成完整备份。
仅云节点模式显示此入口——配置远程节点自托管用户的数据本来就在自己机器上。
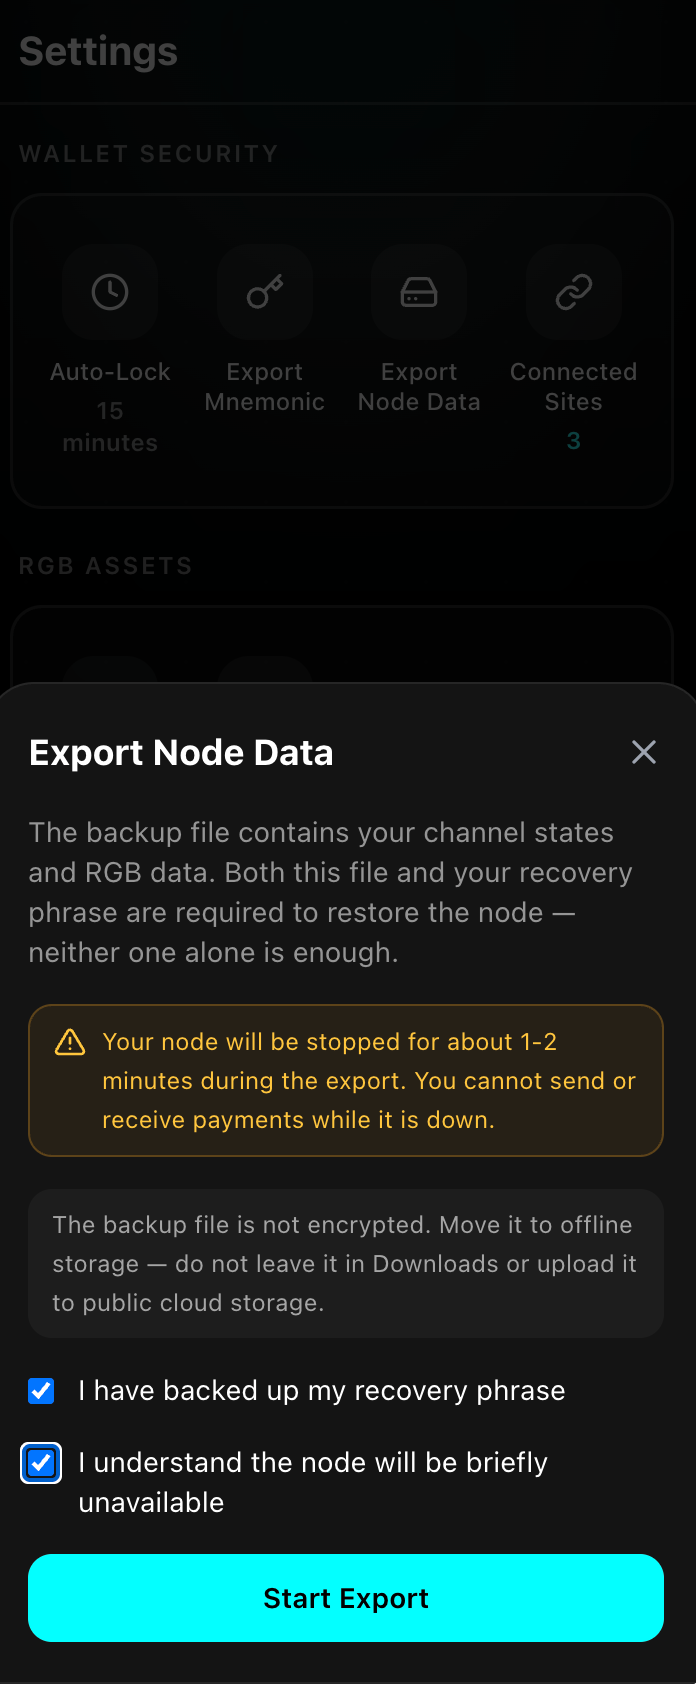
步骤 1:阅读说明,勾选两项前置条件
打开「Export Node Data」弹框,先说明两件事:
- 备份文件包含通道状态与 RGB 数据,它和助记词是一套东西,缺任何一个都无法恢复节点。
- 导出期间节点会停机约 1–2 分钟,期间无法收付款——建议在没有待处理交易时进行。
两个勾选项必须都勾上才能点「Start Export」:「我已备份助记词」 和 「我理解节点会短暂不可用」。前者的意义在于,只有备份文件却没有助记词是恢复不了的,勾选是在导出前把这件事讲明白。
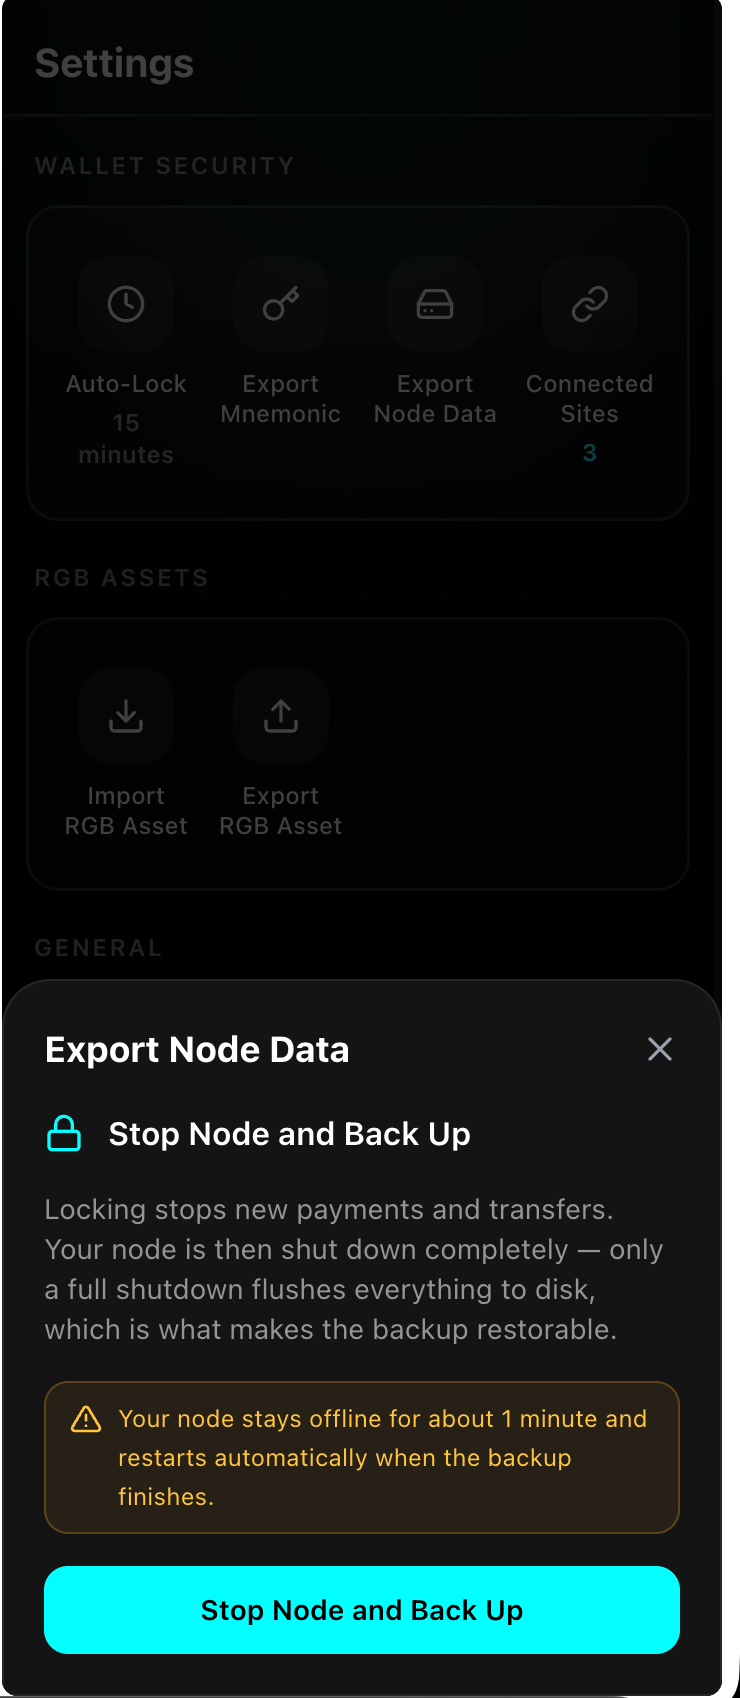
步骤 2:二次确认「停止节点并备份」
第二步单独说明为什么必须停机:锁定只挡住新的支付与转账,只有节点完整关停才会把所有数据刷到磁盘,这才是备份可恢复的前提。确认后点「Stop Node and Back Up」正式开始。
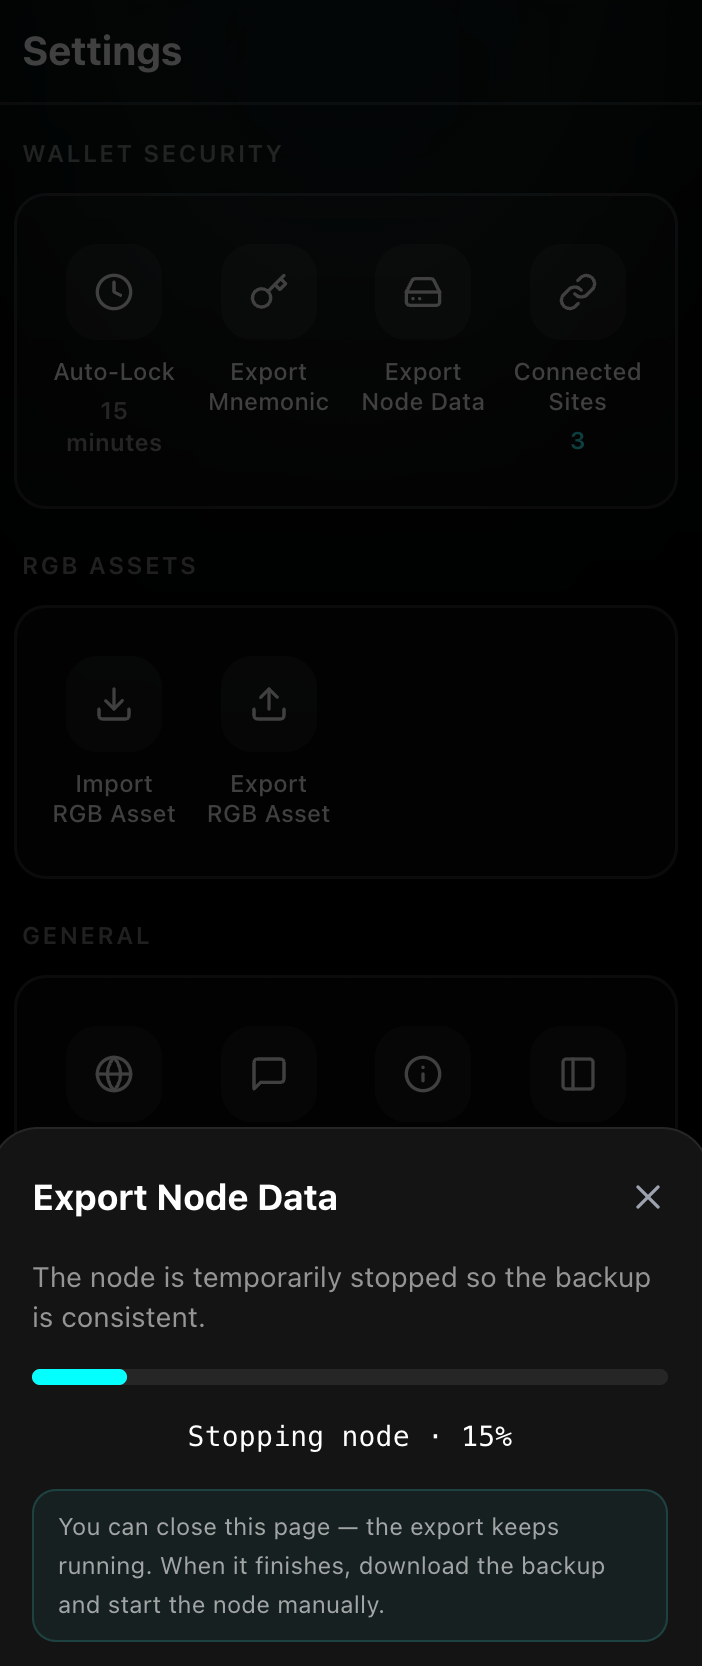
步骤 3:等待导出完成
进度条按真实阶段推进(锁定 → 停机 → 导出 → 上传),图中停在 Stopping node · 15%。
可以直接关掉这个页面,导出会继续在后台跑;再打开时进度视图会恢复。完成后回来下载备份文件、并手动把节点启动起来。
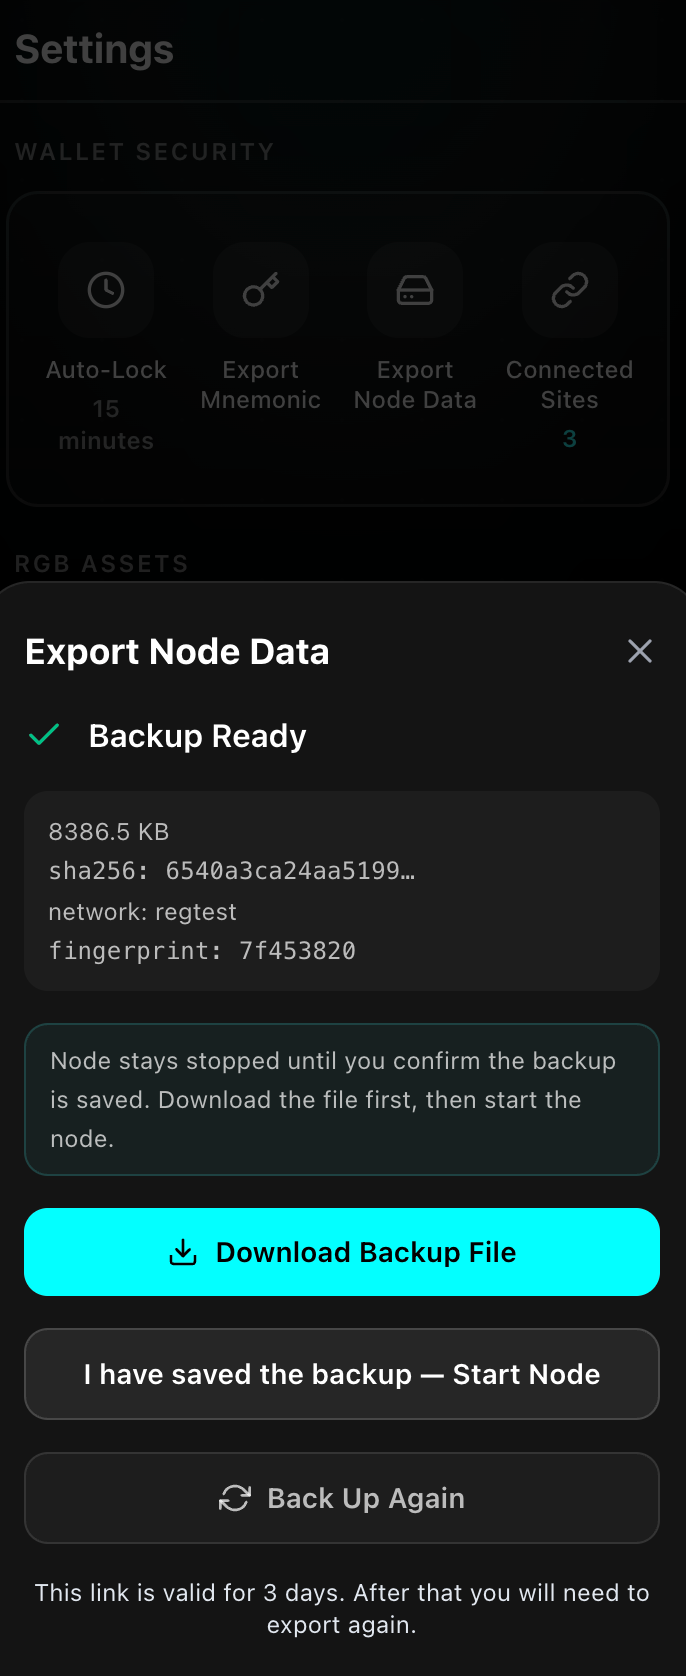
步骤 4:下载备份,再启动节点
完成后显示「Backup Ready」和归档摘要:文件大小、sha256 前 16 位、network、master fingerprint。
这里有个刻意的设计:节点不会自动拉起,而是停在关停状态,等用户确认备份已经保存好。 顺序是先「Download Backup File」,再点「I have saved the backup — Start Node」。如果对这次归档不放心,也可以「Back Up Again」重做一次。
下载链接有效期 3 天,过期后需要重新导出。
七、用户侧:在 Bitlight Control Panel 恢复
导出的归档遵循上游 rgbldkd 的标准格式,可以直接被 Bitlight RGB LDK Control Panel 读取和恢复。这是我们做这个功能的最终目的:不是导出一个只能存着的文件,而是让用户真的能自己跑起来。
恢复前请准备好两样东西
- 原始助记词——与导出时使用的必须完全一致。备份里不含私钥材料,助记词是重建它的重要凭据。
- 备份归档
.tar——从 Stash Wallet 下载的那个文件。
缺任何一个都无法完成恢复。导入时会校验 master_fingerprint,不匹配直接拒绝。
步骤 1:安装并启动 Control Panel,选择 Local Node
从上游仓库获取安装包并启动,确保本机 Docker 正在运行。macOS/Windows 用户需确认归档所在目录在 Docker Desktop 的 File Sharing 白名单内,否则挂载会失败。
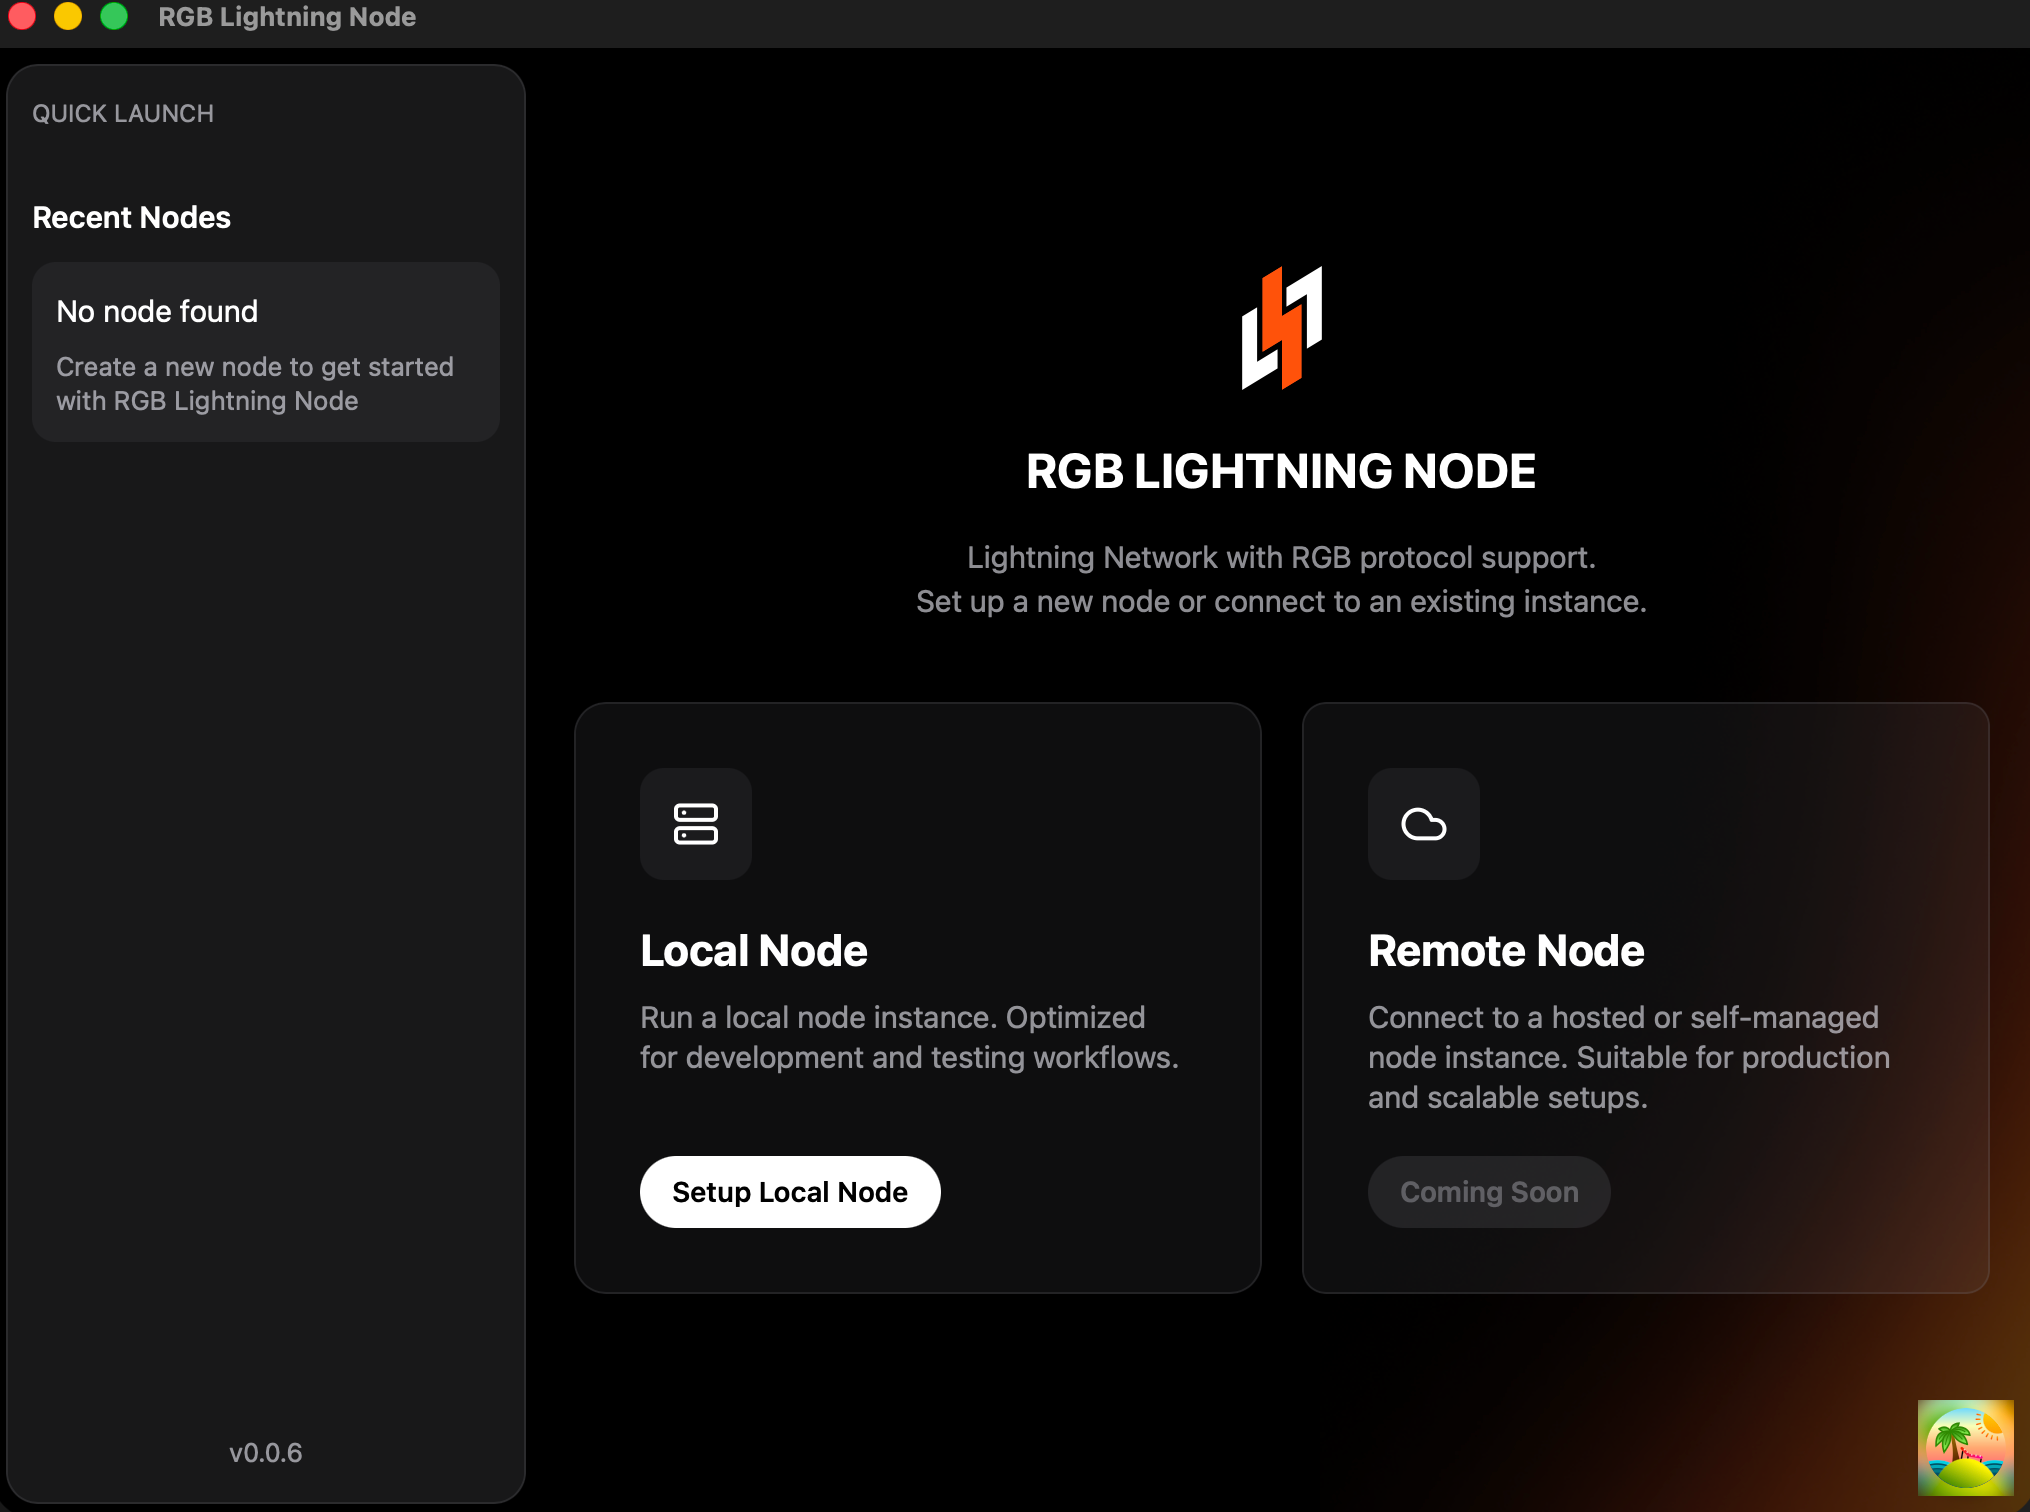
首屏左侧是「Recent Nodes」(首次启动为空),右侧两个入口:Local Node(在本机跑节点)与 Remote Node(连接远端实例,当前 Coming Soon)。恢复走 Setup Local Node。
regtest 必须指向导出时那条链的 esplora
归档里的 BDK 钱包状态记录了它同步到的区块高度(checkpoint)。恢复时如果节点连的是另一条 regtest 链,checkpoint 接不上本地链,节点会在启动阶段同步失败并自动停止,UI 上报 start node failed: WalletOperationFailed。
导入本平台导出的归档时,regtest 的 esplora 必须是:
VITE_REGTEST_API=https://esplora-regtest.stashlabs.io需要注意的是,改 .env 可能不生效。上游仓库的 scripts/bootstrap-local.sh 里有一行:
export VITE_REGTEST_API=http://host.docker.internal:3003它会拉起一套本地 bitcoind + esplora(只挖 101 个块)并把变量 export 进进程环境。Vite 的优先级是进程环境变量高于 .env 文件,所以只要用这个脚本启动,.env 里的值就会被覆盖,重启也没用。这套本地闭环用于新建钱包没有问题,但导入本平台的归档就必然撞上链不匹配。
绕过办法是不走脚本,直接启动并显式传值:
VITE_REGTEST_API=https://esplora-regtest.stashlabs.io pnpm tauri dev或把脚本里那行改成默认值语法,让外部传入优先:
export VITE_REGTEST_API="${VITE_REGTEST_API:-http://host.docker.internal:3003}"esplora 地址在创建节点时就被写入节点上下文和容器启动参数,建节点之后再改不会生效。若已用错误地址建过节点,需修正上下文里的 esplora_url 并删除容器(保留数据卷即可保住已导入的数据),再重新启动、解锁。
步骤 2:填入助记词与归档,恢复钱包
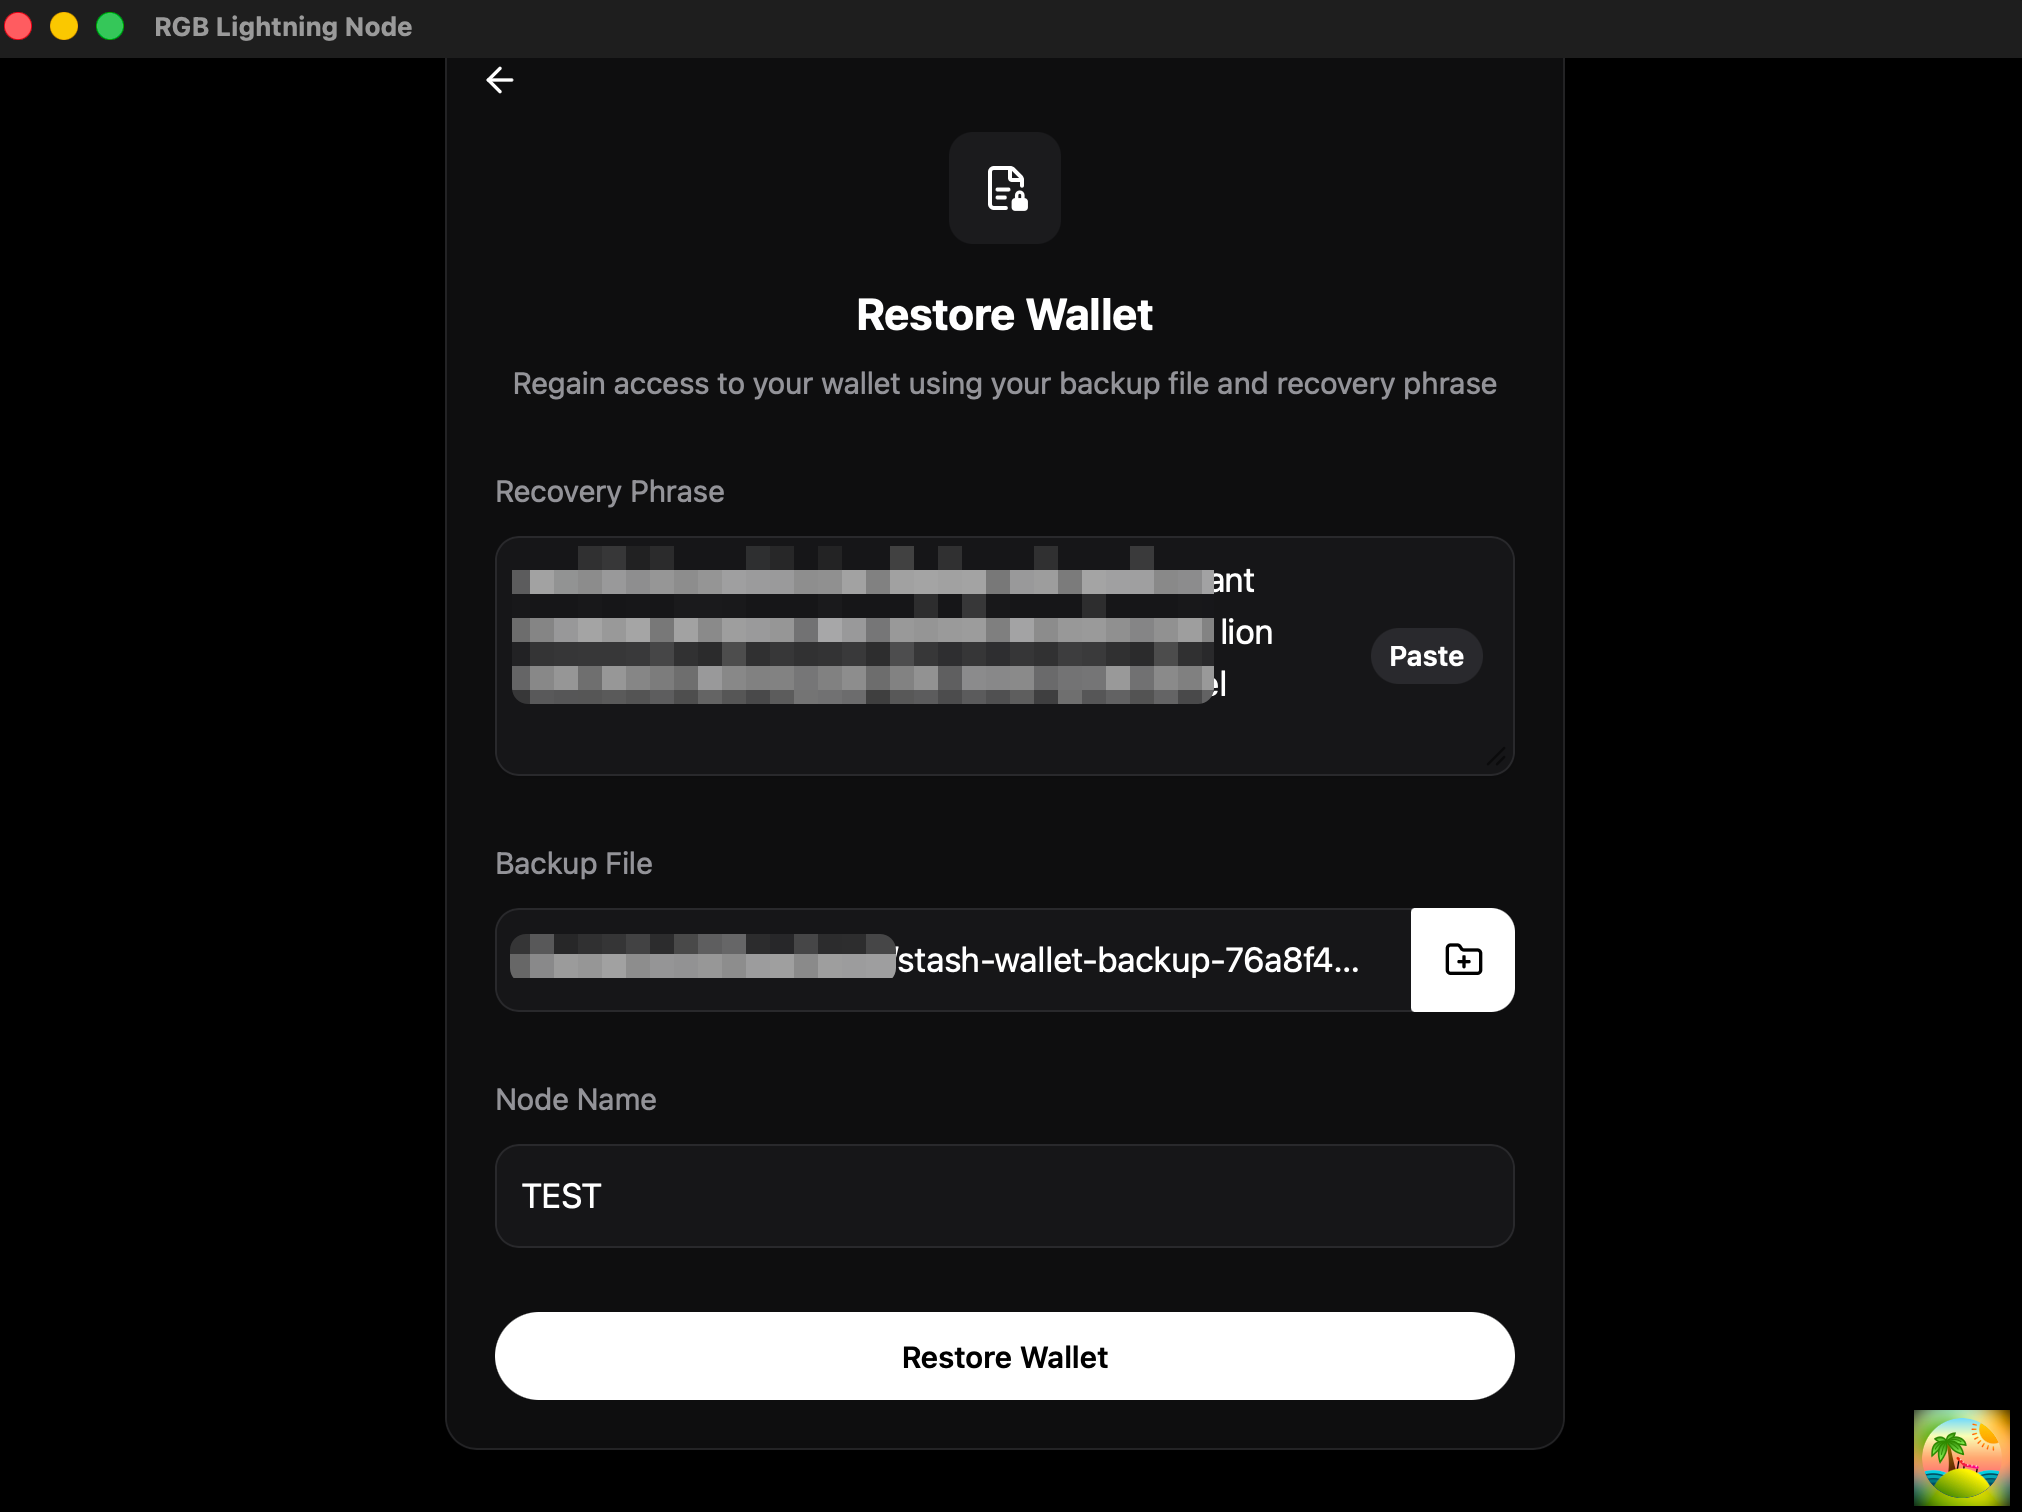
进入「Restore Wallet」页面,填三个字段:
- Recovery Phrase——导出时那个钱包的助记词,可直接「Paste」粘贴。
- Backup File——从 Stash Wallet 下载的
stash-wallet-backup-*.tar。 - Node Name——本地节点的名字,随意取(图中为
TEST)。
点「Restore Wallet」开始恢复。这一步会校验归档 manifest.json 里的 master_fingerprint 与助记词推导出的指纹是否一致,不匹配会直接拒绝——「拿错备份」或「用错助记词」在这里就被挡住,不会产出一个能启动但状态错乱的节点。
步骤 3:核对余额与资产
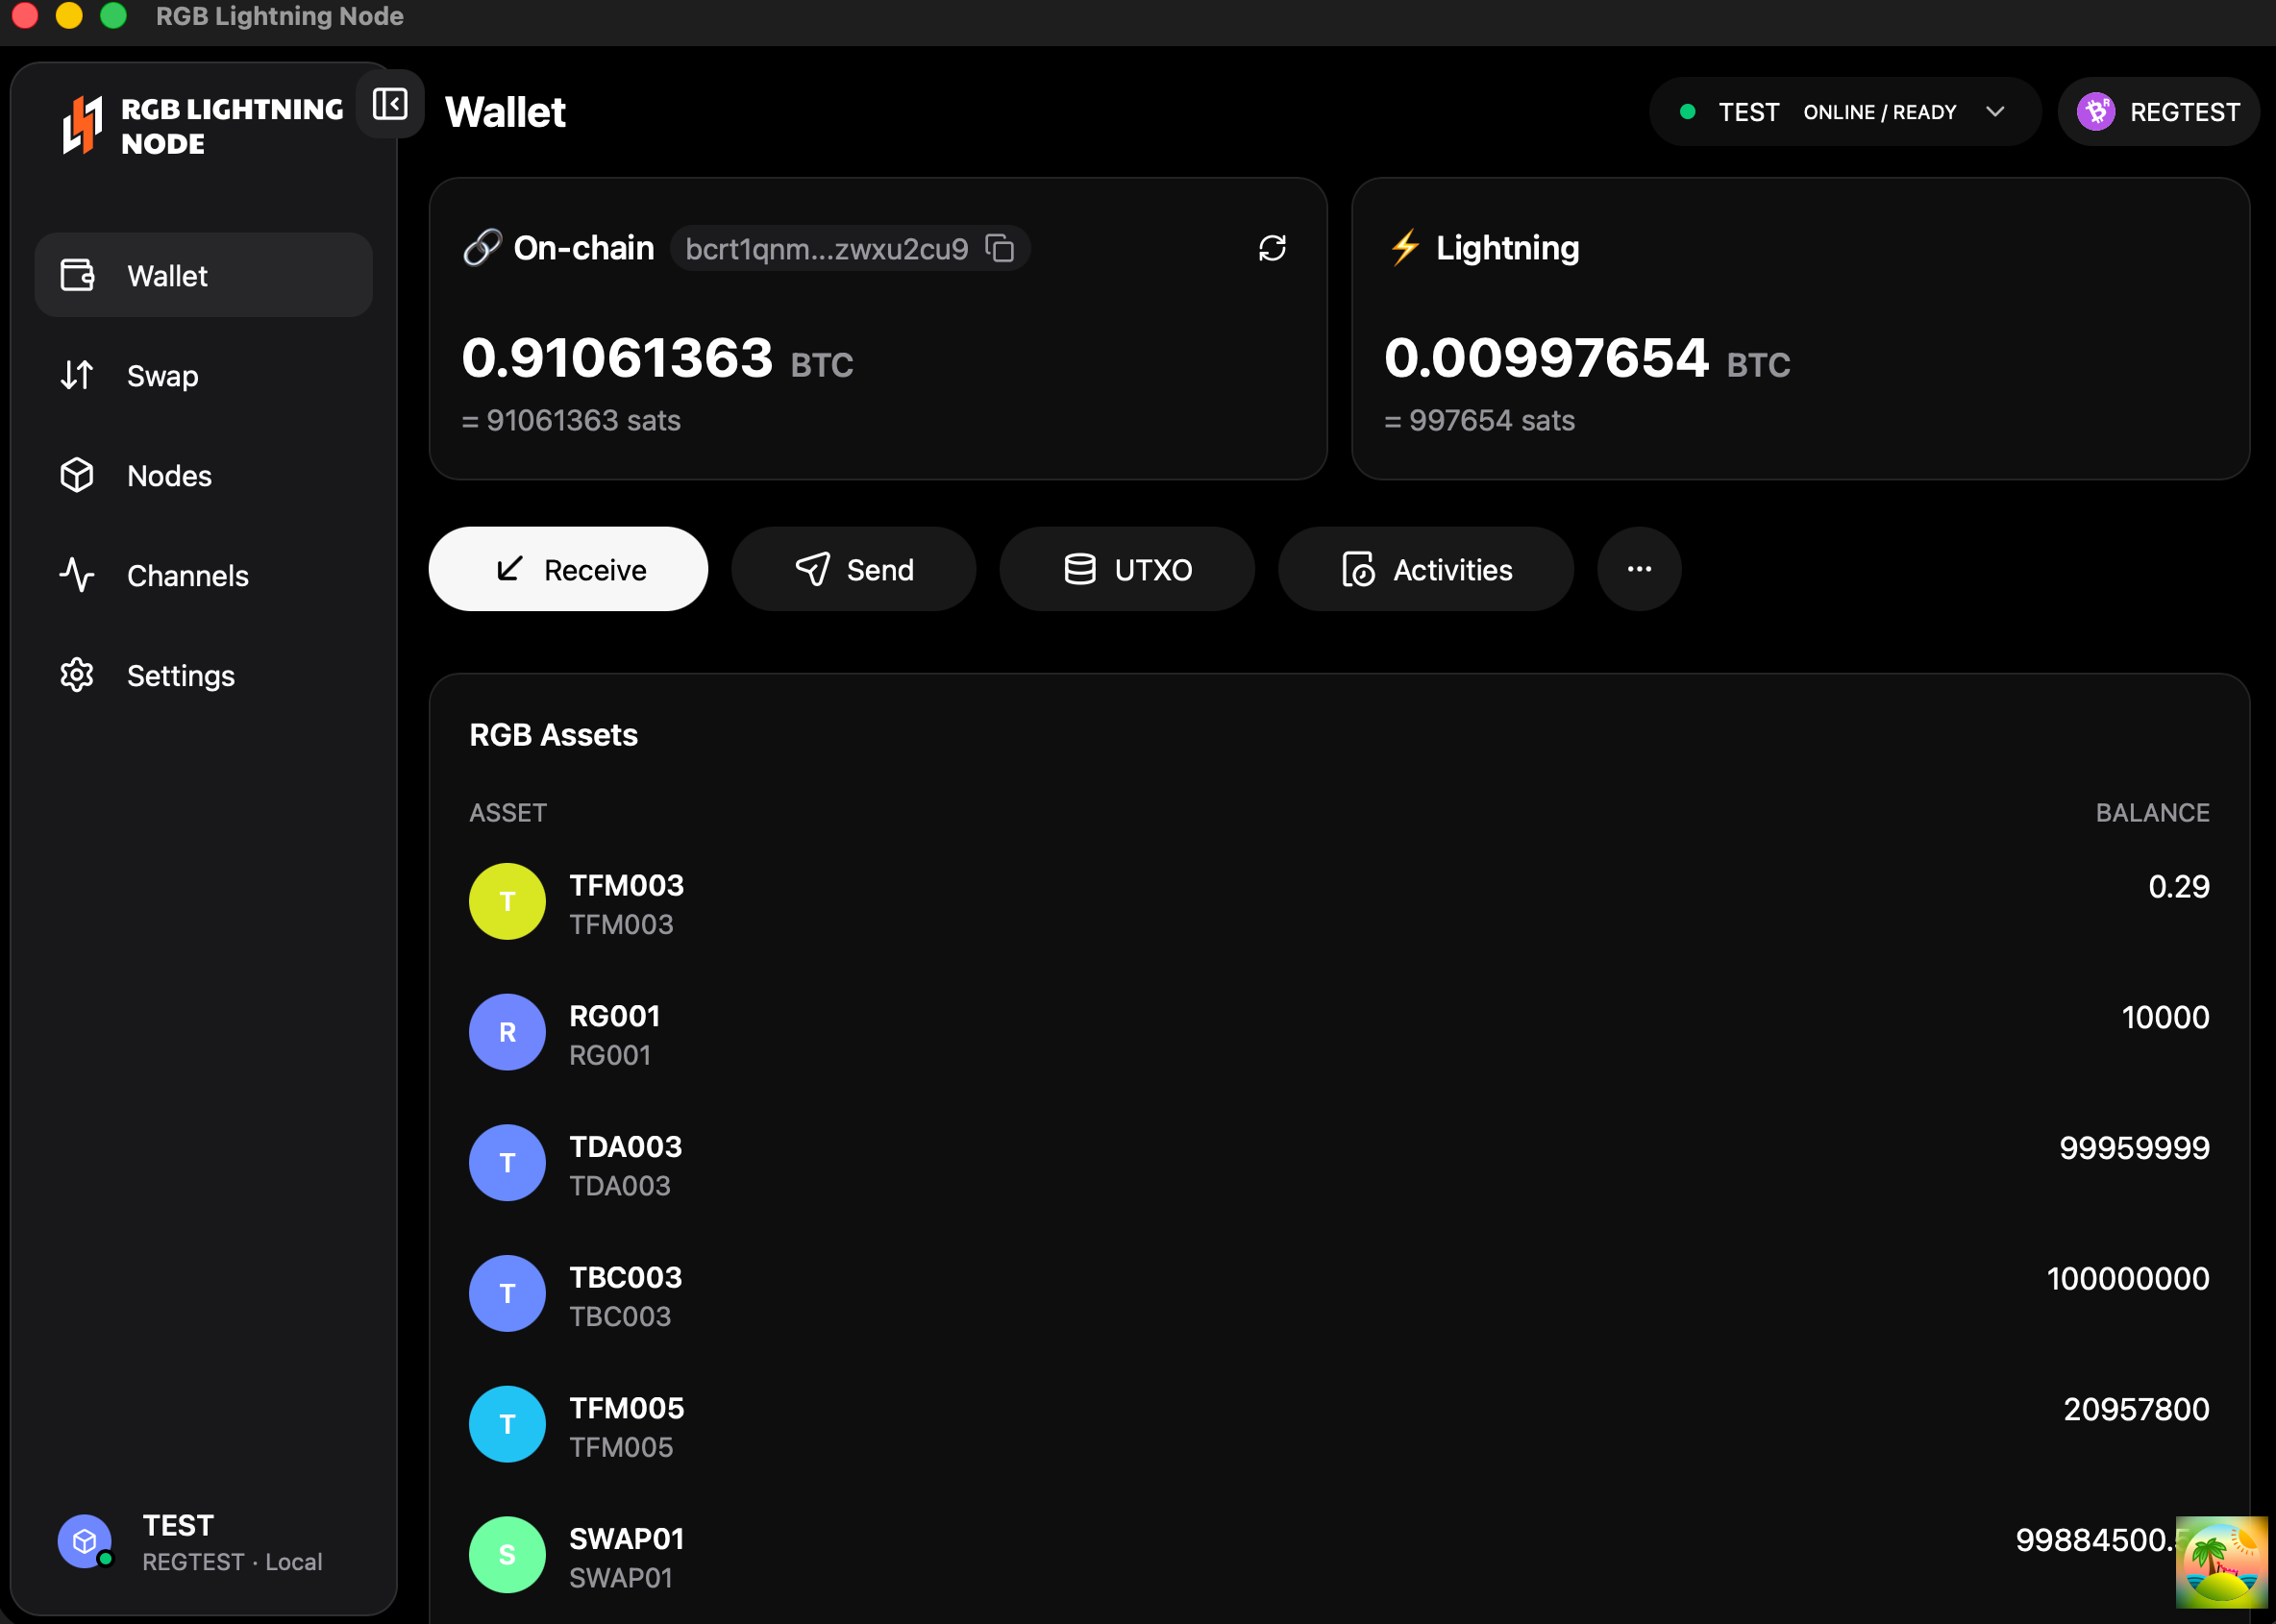
恢复完成后节点启动,右上角显示节点名与 ONLINE / READY,以及当前网络(图中 REGTEST)。
这是整条链路真正的验收点:核对链上余额、闪电余额与 RGB 资产列表是否与导出前一致。 左侧 Channels 页可进一步确认通道是否都回来了。
同一份通道状态只能有一个节点在线
恢复之后,绝不能让同一份通道状态在两个地方同时运行。 云节点和自托管节点同时在线,意味着两边会用同一批承诺交易与对手方交互,很容易触发对手方的惩罚路径(强制关闭 + 罚没)。这是闪电网络的固有约束,不是实现缺陷。
正确顺序:确认自托管节点工作正常后,先在 Stash Wallet 里停用云节点,再开始使用自托管节点。 不要跳过这一步,也不要把顺序颠倒。
八、可靠性验证
选了方案 A,风险就集中在「停机—恢复」这条链路上。所以上线前的硬门槛不是「导出能成功」,而是各种异常下用户节点都能回来,且备份确实可用。
我们按三层来验证,每层回答一个不同的问题。
8.1 单元测试:编排参数对不对
第一层覆盖那些「写错了但跑起来看不出问题」的地方:临时任务的资源编排是否符合预期、并发下任务抢占是否只有一个成功、失败分类是否稳定映射成对用户有意义的错误提示、下载凭据的校验与过期判定是否正确。
这一层的价值在于:这类错误在人工测试里往往表现为「偶尔失败」,只有断言写在代码里才能被稳定地挡住。
8.2 混沌测试:异常中断后节点还能不能回来
这是三层里最关键的一层,因为它决定的不是「功能好不好用」,而是会不会造成用户节点永久损坏。
我们逐一注入了这条链路上每个环节的失败:管理进程在导出中途被杀、临时任务始终无法启动、数据盘卸载超时、上传失败、节点重新拉起失败、同一用户并发触发多次导出。
每个场景的验收标准都一样:任务必须推进到明确的终态,用户节点必须已经恢复,且不留下任何会占住数据盘的残留资源。
这一层不过,功能无法上线。 一个偶尔会让用户节点起不来的备份功能,比没有备份功能更糟。
8.3 端到端测试:备份到底能不能恢复
前两层证明流程是健壮的,但都没有回答最根本的问题:导出来的东西真的能用吗?
所以端到端的验收标准不是「导出成功」,而是完整走通一条真实链路:建节点 → 开通道 → 收发 RGB 资产 → 导出 → 确认备份后节点重新启动、通道仍在、可继续收付款 → 在 Bitlight Control Panel 上完成恢复 → 通道回来、资产余额与导出时一致。
其中最后一步是不可替代的:用开源产品去读我们产出的归档,是判断格式契约是否真的对齐的唯一办法。 能被 Control Panel 正确识别并恢复,才证明我们产出的是标准备份,而不是自造了一个「看起来像的备份文件」。这也是我们敢在文档里承诺「可自托管」的依据——不是因为格式看起来兼容,而是因为真的跑通过。
我们还专门验证了几个用户容易踩的错误路径:用错助记词恢复、归档被截断或篡改、网络类型不匹配。这些场景必须在恢复的第一步就明确报错,而不是产出一个能启动但状态错乱的节点——错得明确,比错得隐蔽安全得多。
九、小结
节点数据导出是一个「平时不觉得重要、出事了无比重要」的功能。它的设计难点不在导出逻辑,而在于:在云节点环境的存储约束下,如何在不牺牲备份可靠性的前提下,把数据所有权真正交回用户手里。
方案选择的核心是一个价值判断:在「不停机」和「一定能恢复」之间,哪个更不能让? 我们的答案是后者。备份可以让用户多等一分钟,但不能让用户赌——一个概率性的备份,在需要它的那一刻和没有备份没什么区别。
上述验证还顺带证明了另一件事:Stash 的技术栈——Stash Cloud 与 Stash Wallet——与上游保持 100% 兼容。 Stash Cloud 产出的归档能被上游的 RGB LDK Control Panel 直接读取并完整恢复,Stash Wallet 的助记词体系也能在上游产品里重建出同一个钱包。这意味着,用户随时可以带着数据离开这套云节点服务,落到上游开源实现上继续跑——节点数据不被平台锁定,这是工程实现,不只是承诺。